ML 研究者的三层基本功——从 Kimi 的 Attention Residuals 说起
ML · · 阅读 13 分钟
我在思考,一位合格的 ML Researcher 应该具备怎样的基础能力?没有一个好的基础,谈创新性的想法、好的品味等等,完全是空中楼阁。
让我们着眼于前沿作品,看看一项优秀的现代 ML 架构研究应该包含哪些部分,我们读懂、复现乃至在其基础上创新需要准备怎样的能力,以及如何培养这些能力。
三个层次
一个完整的现代 ML 架构研究,通常由三个层次组成:
- 模型定义层(算什么):对架构做了什么改动?为什么它能让模型变得更好?
- 算法层(怎么算):在计算结果不变的前提下,如何重新组织计算,让它更省计算量和显存读写?
- 系统层(在哪算):如何把计算落到具体的硬件和集群上,解决显存、通信、并行和部署的问题?
三层的衡量标准也不同:模型层看效果(loss、benchmark),算法层看理论成本(计算量、显存读写量),系统层看实测(吞吐、延迟、显存占用、成本)。三者的边界也并不总是泾渭分明,FlashAttention 这类工作就同时横跨算法层和系统层。
提出一个好的创新点,往往只是第一步。一个想法在小模型上有效,不代表它能在大规模集群上训练、在线上低延迟地服务用户;这些都是算法层和系统层要解决的实打实的工程问题(可见 CS 基础多么重要)。
下面以 Kimi 的研究 Attention Residuals(AttnRes)为例看看这三层是如何在一个具体的架构研究中体现,再反过来谈谈怎么学这三层的能力。
以 Kimi Attention Residuals 为例
它的想法其实很明晰易懂:Attention Residuals (简称为 AttnRes) 把 Transformer 各层之间的残差连接,从“所有层输出等权相加”换成“沿深度方向做 softmax attention”——就像传统 Transformer 在 token 方向对 RNN 做的改进。
第一层:模型定义
基础动机是:在常用的 PreNorm 结构下,hidden state 会随深度不断变大,每一层输出所占的分量越来越小,早期层的信息被淹没。
Kimi 团队从这个想法出发构造了 Full AttnRes;又为了节省内存和跨卡通信开销(工程驱动的想法),构造了 Block AttnRes;并引入 DenseFormer、mHC 等类似的 baseline 做对比。
想法提出之后,还要证明它确实有效:用 scaling law 说明收益在不同规模上都成立,再用消融实验说明到底是哪个部件在起作用。
第二层:算法
考虑,如何让新的架构算得更快呢?
比如同一块内所有层的 query 先批量算一次块间 attention,再逐层处理块内部分,用 online softmax 合并。(参考 FlashAttention 的灵感,结果和直接计算完全相同,只是计算顺序变了。)之所以能批量计算,是因为每层的 query 是学出来的固定向量(论文称为伪 query),不依赖输入,在计算开始前就全部已知。
然后衡量这个改进的具体价值:论文先从理论上算出每种残差机制每层的显存读写量,再实测端到端的延迟开销(见第三层)。
第三层:系统
系统上,能够如何改进呢?
一、训练阶段
大规模训练要用流水线并行:把模型的层切成若干段,分给多张卡依次计算,每一段叫一个 stage。Block AttnRes 必须把已累积的块表示(block representation,即每个块内各层输出之和)传给后面的 stage。朴素做法每次交接都传全部历史,如此通信量会随分段数的平方增长;另外,这些块表示要一直留到后面的层用完,显存也会增加。
解决办法:
- 跨 stage 缓存:在交错式(interleaved)流水线里,数据会在卡之间转好几圈,每张卡先后多次处理同一份数据。第一次收到的块表示留在本地,之后只传新增的部分;这样每次的传输量不再随分段数增长,可以藏进计算时间里。
- 显存:activation checkpointing 只存每层的输入,中间结果在反向传播时再重新算一遍,用多算一次换少存一些。
效果:同样一个模型,把标准残差换成 AttnRes 之后,训练会变慢多少?不开流水线并行时可以忽略;开了以后端到端不到 4%。端到端的结论证明这个想法并非天马行空的改进,而是可以真正落地训练的。
二、推理阶段:
长上下文的 prefill(一次性读入整段提示)最吃显存:每个 token 都要存下前面的 8 个(Block AttnRes 把网络分成的块数)块表示,128K token 加起来约 15 GB。第二阶段的合并如果单独算,还会多一轮显存读写。
解决办法:
- 按序列切分:深度方向的 attention 只发生在同一个 token 自己的各层之间,不同 token 互不相干。所以可以把 token 切开,分给张量并行(把每层的矩阵切开、分给多张卡一起算)的 8 张卡,每张卡只存自己那部分,降到每卡约 1.9 GB;再把提示切成 16K 一段逐段处理(chunked prefill),降到 0.3 GB 以下。
- 把合并融进通信:张量并行每层本来就要做 reduce-scatter 和 all-gather,两步之间每张卡手里正好只有一部分 token。趁这个间隙在本地做完合并和 RMSNorm,不增加额外通信。
效果:同样一个模型,换成 AttnRes 之后推理会变慢多少?典型推理负载下,端到端延迟增加不到 2%。
这三层的联系
下层的约束常常反过来决定上层的设计。
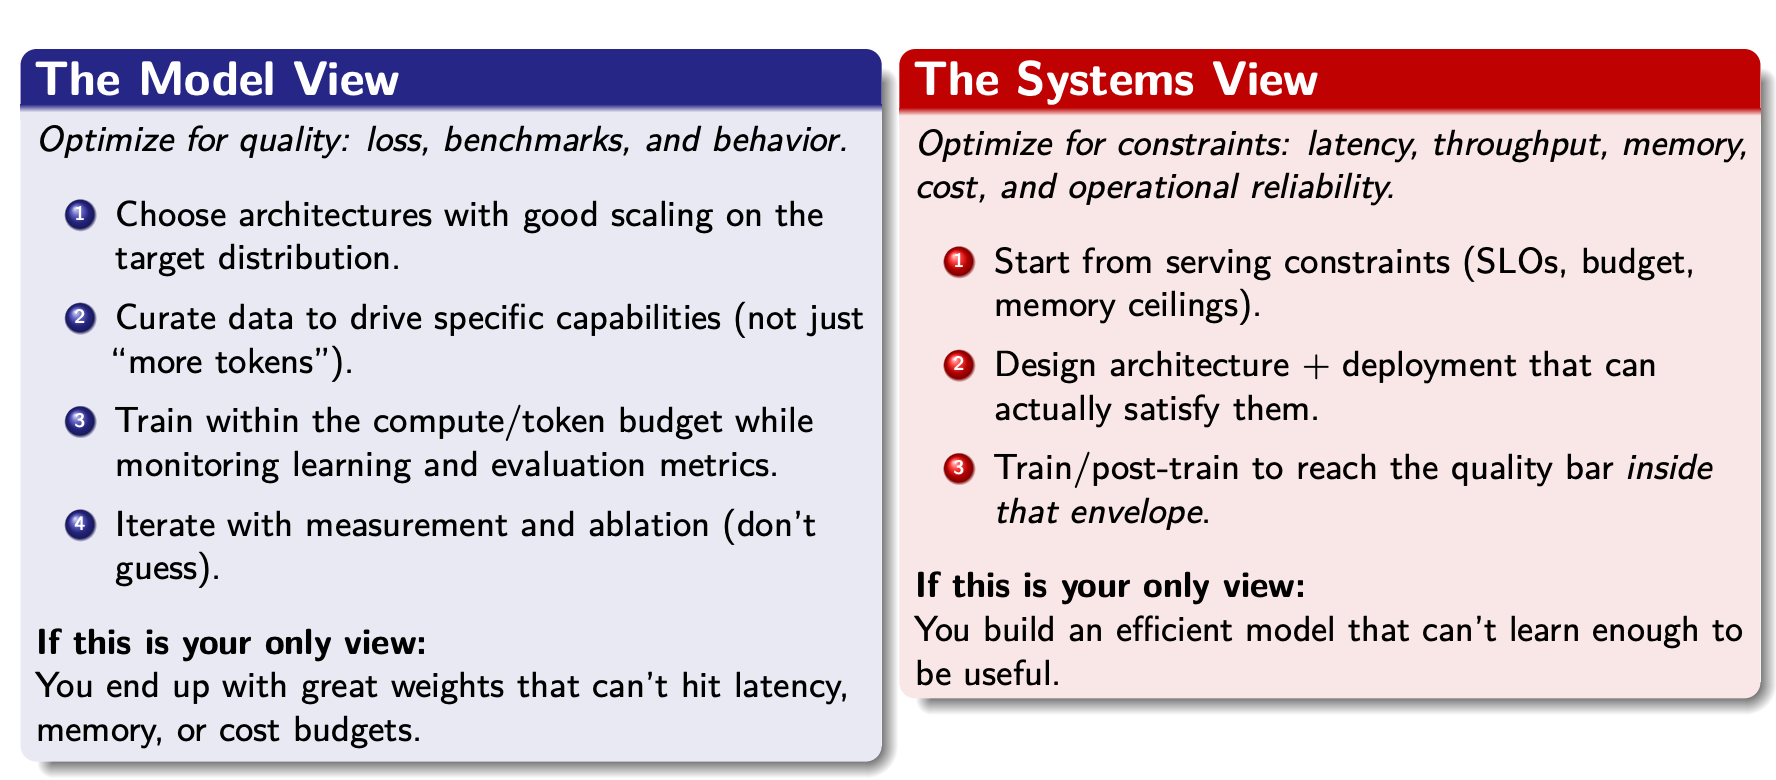
我们可以从两个视角出发,一个是从模型能力 (Model) 的视角,这个优化的目标函数是模型的质量,用 loss, benchmarks, behaviour 等来衡量;另一个是从系统工程 (System) 的视角,考虑如何能够更快做推理服务用户、如何更快迭代实验等等,由 latency, throughput, memory cost 等来衡量。
只有模型视角,你会得到一组效果很好、但达不到延迟、显存或成本要求的权重;只有系统视角,你会得到一个很高效、但学不到足够东西的模型。
AttnRes 里有三处是系统决定模型:
- Block AttnRes 本身:Full AttnRes 在流水线并行下要传 O(Ld) 的层输出,当前的互联带宽扛不住,所以才有了块。
- 伪 query 不依赖输入:这是第二层批量计算成立的前提。消融里依赖输入的 query 其实更好,但没有被采用。
- 块数固定在 8 个左右:Full AttnRes 的效果最好,更细的分块也更接近它;作者明说,固定 N≈8 是出于 infra 效率,等硬件放松了再换更细的粒度。
同样的结构也出现在学术界的工作里。另一个学术团队在 AttnRes 之后提出的 Depth Memory(LDM)能在深度方向用精确的递推最小二乘(RLS),是因为层本来就是顺序计算的,不需要序列方向那种可并行的近似解;RLS 又恰好可逆,于是反向传播时可以从最后一层倒推状态,省掉逐层存储。
但两篇论文的系统层回答的问题不同。Kimi 是在 48B MoE 上做验证、目标是用到生产模型里的工业团队,关心流水线通信、长上下文 prefill 和部署延迟;Depth Memory 是学术组,关心单卡 kernel 速度和激活显存。系统层回答什么问题,往往取决于研究人员所在的位置。
所以,读架构论文时,值得对每个设计的选择都问一句:这个取舍是为了效果,还是为了系统?系统工程能力是万万不可缺的,很多设计都是由工程驱动的。
(想到一句流行的说法: “教一个 Researcher 如何做好 Engineering,要远比教一个 Engineer 如何做好 Research 来得难”。)
如何学这三层
作为研究者,没必要三层都深入了解,对于每一个层次做到读得懂(知道为什么这样设计)、会使用对应的简单框架就好了。并且可以选择一块深入研究,和不同能力的朋友合作。
1. 模型定义层
(a) 需要具备什么能力
- 熟悉现代模型的各个组件,知道每个设计在解决什么问题、付出什么代价:attention 及其变体(MHA、GQA、MLA、稀疏与线性注意力、状态空间模型)、归一化的位置、残差与深度方向的信息流、MoE、位置编码。
- 理解训练的规律:scaling law;训练稳定性(初始化、学习率与 warmup、loss spike);超参数如何随规模迁移。
- 能精读论文:还原作者的论证,区分“作者的观点”和“实验数据实际支持什么”;以及可以换位思考一下,如果你是作者,你会怎么论证和实验?
- 能设计严谨的实验:控制变量、消融、多个 seed、多个尺寸的趋势、为每个方法单独调参,用小规模实验得到可信的结论。
- 能找到好问题:从数据和主流说法对不上的地方(比如作者叙述和自己实验对不上的地方、两篇论文的数据矛盾的地方等等),或者从跨领域的类比里找切入点。
(b) 资源
- 课程:Stanford CS336(Language Modeling from Scratch);Berkeley Scalable AI 的架构与预训练部分。
- 经典代码:nanoGPT 这类精简实现;OLMo 这类代码、数据、训练日志全部公开的模型。
- 经典论文:Transformer 原文;Chinchilla 的 scaling law;近年开源模型的技术报告,如 DeepSeek-V3、Qwen3。
2. 算法层
(a) 需要具备什么能力
- 估算成本:给一个算子估算计算量和显存读写量,判断瓶颈在哪里。
- 重排计算:利用结合律、分块、递推形式与并行形式的转换,找到结果相同、成本更低的算法。典型例子是 online softmax 和线性注意力的分块并行算法。
- 数值线性代数与数值稳定性:矩阵分解、最小二乘、低秩结构;知道低精度下哪里会溢出或失准。
- 把模型改动翻译成算法问题:一个新结构能不能并行?能不能分块?中间结果能不能不存?
(b) 资源
- 论文:FlashAttention 1、2,硬件感知算法设计的范本;Mamba-2 的 SSD 论文(Transformers are SSMs),线性注意力与状态空间模型的统一视角。
- 博客:Songlin Yang 的 DeltaNet 系列;苏剑林的“科学空间”。
- 教材:Trefethen 和 Bau 的《Numerical Linear Algebra》。
3. 系统层
(a) 需要具备什么能力
- 理解 GPU 的性能模型:显存层级(HBM、SRAM、寄存器)、tensor core、roofline、memory-bound 与 compute-bound、kernel 融合。
- 算清训练的显存账:参数、梯度、优化器状态、激活各占多少;重计算如何用时间换空间。
- 理解分布式训练:数据并行与 FSDP、张量并行、流水线并行、专家并行,各自要传什么、通信成本多大。
- 理解推理系统:prefill 与 decode、KV cache、批处理与调度。
- 理解数值精度:BF16、FP8、FP4 各自的取舍。
- 会用工具:用 profiler 找瓶颈;必要时用 Triton 写简单的 kernel。
(b) 资源
- 入门直觉:Horace He 的 Making Deep Learning Go Brrrr From First Principles。
- 大模型系统:How to Scale Your Model;Hugging Face 的 Ultra-Scale Playbook;vLLM、SGLang 的文档与源码。
- 动手:Triton 官方教程;GPU MODE 社区讲座;《Programming Massively Parallel Processors》。
- 课程:UC Berkeley Scalable AI 的性能、并行与推理部分;UC Berkeley CS 61C 体系结构基础。
顺序上,建议先建立基础的 ML 认识,从第一层的读论文和做实验入手,发现知识盲区再选择性地找优质资源学习。通过读论文和优质课程,慢慢建立第三层的性能直觉,然后回看第二层的算法推导——这两层总是交替的。
贯穿三层的练习项目
最好的学法是用一个项目把三层串起来,每一步都落在其中一层上。不必从零设计,现成的课程作业就很好:
- Stanford CS336 的 A2:用 Triton 实现 FlashAttention,再做分布式训练,正好覆盖算法层和系统层。
- UC Berkeley Scalable AI 的 A1(性能工程):作业包在课程主页有开源,是关于性能分析的基本功。
做完之后,可以挑一篇自己感兴趣的架构论文,按三层各走一步:先在小模型上用 PyTorch 把它实现出来(模型层),再用 profiler 找出瓶颈(系统层),最后试着重排计算,或者写一个融合 kernel(算法层和系统层)。
碎碎念
模型层决定做什么,算法层和系统层决定能不能做大、投入生产使用。好的架构研究,是在这三层之间来回调整的结果。第一层需要建模与实验的能力,后两层则与 MLSys 相关。
但是但是,回到初心,最重要的还是 Mindset,你是否真正热爱这个领域,是否愿意慢下来、静下来,一步一步地向前走。
ML 研究不容易,基础要慢下来一点一点打牢。最近读到教授们发起的"慢科研联盟"倡议,深以为然。可现在大家普遍焦虑,而 AI 的飞速发展像一面放大镜,把这种焦虑放得更大。对我来说,焦虑的核心是年龄,总想再早一点做出成绩。
做 ML 研究,对我而言或许是命中注定的,它是我愿意倾尽一生的事业之一。兜兜转转,人总会回到属于自己的位置。高二那年,我记得下课后和一位很要好的朋友讨论数学,那时我们都在学线性代数。了解到机器学习之后,我们说,高考后一定要做这方面的研究。很神奇,从第一次接触这个领域起,我就一直被它吸引,直到今天。本科三年过去,我尝试了全栈开发、区块链、量化投研乃至自己创业做项目做品牌,绕了一大圈。直到第四年,再次回到这里。
我愿意慢慢来,因为从毕生事业的角度看,多等一年和快进一年并没有多少区别。以及我热爱的是做研究本身,每天能够学习前沿新知、有所思考,真的特别幸福。
但慢下来也要求你有所成果,现实的评判体系根深蒂固。加之每个人随着年龄增长都需要面对世俗层面的取舍,二十几岁的青春年华眨眼逝去,社会时钟的压力让我们不得不脚踏具体又粗糙的现实。
我想,战略上要尽可能提升自己的迭代速率,在照顾好身体和生活的前提下,提高学习和实验的效率,把时间聚焦于对的方向;具体到研究本身,则需要慢慢来,扎实把事情做好:)
Reference
- Attention Residuals(Kimi Team, arXiv:2603.15031)
- Depth Memory(arXiv:2610.18809)
- Scalable AI, Fall 2026(UC Berkeley)
( Berkeley)