ML 研究者的三層基本功——從 Kimi 的 Attention Residuals 說起
ML · · 閱讀 13 分鐘
我在思考,一位合格的 ML Researcher 應該具備怎樣的基礎能力?沒有一個好的基礎,談創新性的想法、好的品味等等,完全是空中樓閣。
讓我們著眼於前沿作品,看看一項優秀的現代 ML 架構研究應該包含哪些部分,我們讀懂、復現乃至在其基礎上創新需要準備怎樣的能力,以及如何培養這些能力。
三個層次
一個完整的現代 ML 架構研究,通常由三個層次組成:
- 模型定義層(算什麼):對架構做了什麼改動?為什麼它能讓模型變得更好?
- 算法層(怎麼算):在計算結果不變的前提下,如何重新組織計算,讓它更省計算量和顯存讀寫?
- 系統層(在哪算):如何把計算落到具體的硬件和集群上,解決顯存、通信、並行和部署的問題?
三層的衡量標準也不同:模型層看效果(loss、benchmark),算法層看理論成本(計算量、顯存讀寫量),系統層看實測(吞吐、延遲、顯存佔用、成本)。三者的邊界也並不總是涇渭分明,FlashAttention 這類工作就同時橫跨算法層和系統層。
提出一個好的創新點,往往只是第一步。一個想法在小模型上有效,不代表它能在大規模集群上訓練、在線上低延遲地服務用戶;這些都是算法層和系統層要解決的實打實的工程問題(可見 CS 基礎多麼重要)。
下面以 Kimi 的研究 Attention Residuals(AttnRes)為例看看這三層是如何在一個具體的架構研究中體現,再反過來談談怎麼學這三層的能力。
以 Kimi Attention Residuals 為例
它的想法其實很明晰易懂:Attention Residuals (簡稱為 AttnRes) 把 Transformer 各層之間的殘差連接,從“所有層輸出等權相加”換成“沿深度方向做 softmax attention”——就像傳統 Transformer 在 token 方向對 RNN 做的改進。
第一層:模型定義
基礎動機是:在常用的 PreNorm 結構下,hidden state 會隨深度不斷變大,每一層輸出所佔的分量越來越小,早期層的信息被淹沒。
Kimi 團隊從這個想法出發構造了 Full AttnRes;又為了節省內存和跨卡通信開銷(工程驅動的想法),構造了 Block AttnRes;並引入 DenseFormer、mHC 等類似的 baseline 做對比。
想法提出之後,還要證明它確實有效:用 scaling law 說明收益在不同規模上都成立,再用消融實驗說明到底是哪個部件在起作用。
第二層:算法
考慮,如何讓新的架構算得更快呢?
比如同一塊內所有層的 query 先批量算一次塊間 attention,再逐層處理塊內部分,用 online softmax 合併。(參考 FlashAttention 的靈感,結果和直接計算完全相同,只是計算順序變了。)之所以能批量計算,是因為每層的 query 是學出來的固定向量(論文稱為偽 query),不依賴輸入,在計算開始前就全部已知。
然後衡量這個改進的具體價值:論文先從理論上算出每種殘差機制每層的顯存讀寫量,再實測端到端的延遲開銷(見第三層)。
第三層:系統
系統上,能夠如何改進呢?
一、訓練階段
大規模訓練要用流水線並行:把模型的層切成若干段,分給多張卡依次計算,每一段叫一個 stage。Block AttnRes 必須把已累積的塊表示(block representation,即每個塊內各層輸出之和)傳給後面的 stage。樸素做法每次交接都傳全部歷史,如此通信量會隨分段數的平方增長;另外,這些塊表示要一直留到後面的層用完,顯存也會增加。
解決辦法:
- 跨 stage 緩存:在交錯式(interleaved)流水線裡,數據會在卡之間轉好幾圈,每張卡先後多次處理同一份數據。第一次收到的塊表示留在本地,之後只傳新增的部分;這樣每次的傳輸量不再隨分段數增長,可以藏進計算時間裡。
- 顯存:activation checkpointing 只存每層的輸入,中間結果在反向傳播時再重新算一遍,用多算一次換少存一些。
效果:同樣一個模型,把標準殘差換成 AttnRes 之後,訓練會變慢多少?不開流水線並行時可以忽略;開了以後端到端不到 4%。端到端的結論證明這個想法並非天馬行空的改進,而是可以真正落地訓練的。
二、推理階段:
長上下文的 prefill(一次性讀入整段提示)最吃顯存:每個 token 都要存下前面的 8 個(Block AttnRes 把網絡分成的塊數)塊表示,128K token 加起來約 15 GB。第二階段的合併如果單獨算,還會多一輪顯存讀寫。
解決辦法:
- 按序列切分:深度方向的 attention 只發生在同一個 token 自己的各層之間,不同 token 互不相干。所以可以把 token 切開,分給張量並行(把每層的矩陣切開、分給多張卡一起算)的 8 張卡,每張卡只存自己那部分,降到每卡約 1.9 GB;再把提示切成 16K 一段逐段處理(chunked prefill),降到 0.3 GB 以下。
- 把合併融進通信:張量並行每層本來就要做 reduce-scatter 和 all-gather,兩步之間每張卡手裡正好只有一部分 token。趁這個間隙在本地做完合併和 RMSNorm,不增加額外通信。
效果:同樣一個模型,換成 AttnRes 之後推理會變慢多少?典型推理負載下,端到端延遲增加不到 2%。
這三層的聯繫
下層的約束常常反過來決定上層的設計。
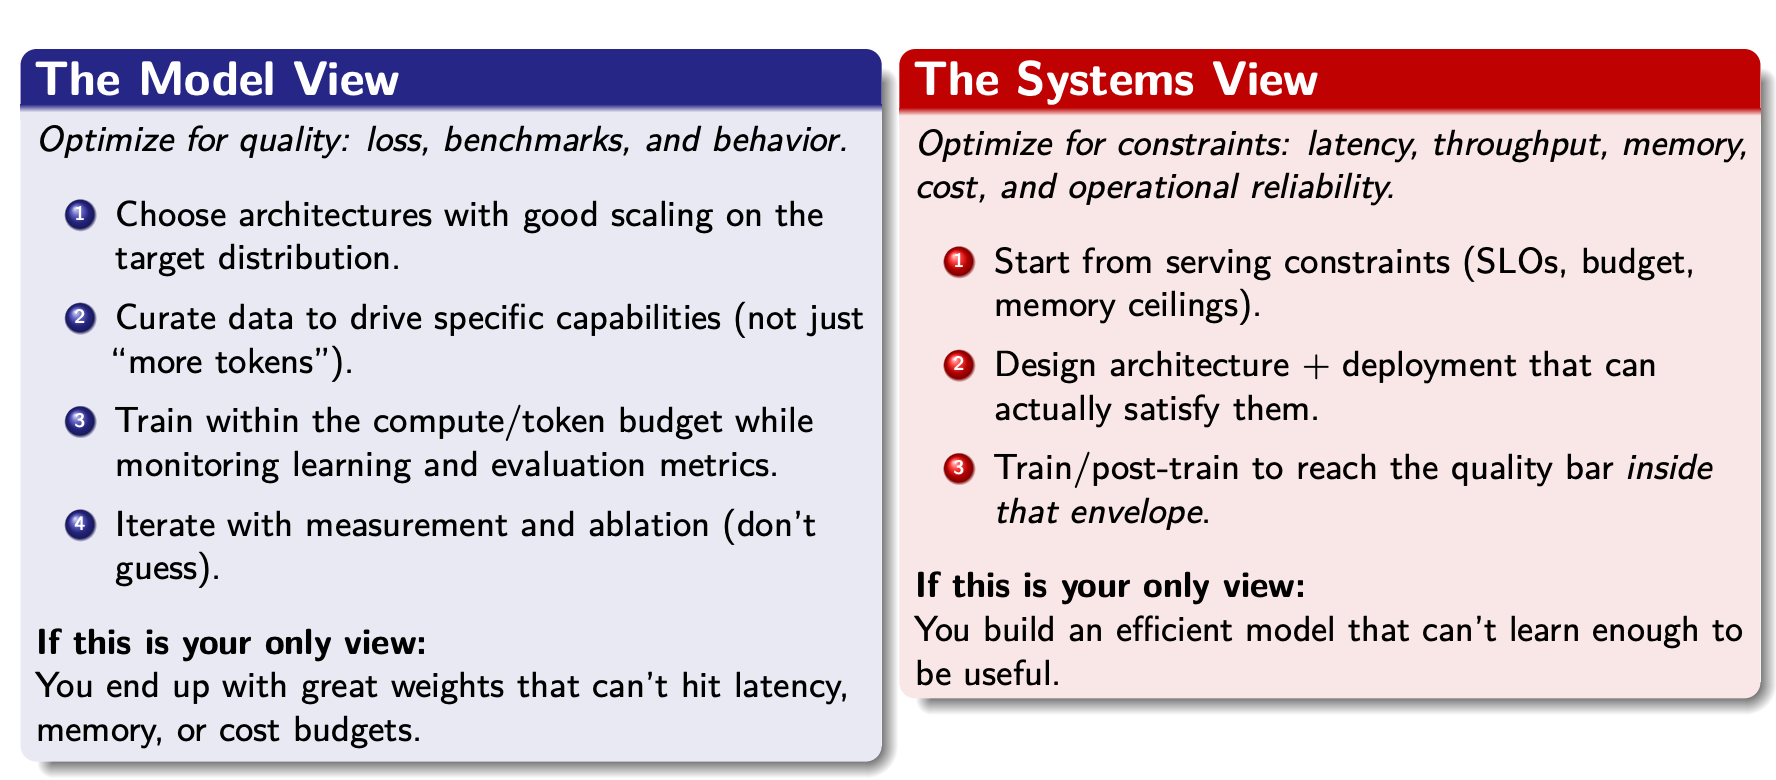
我們可以從兩個視角出發,一個是從模型能力 (Model) 的視角,這個優化的目標函數是模型的質量,用 loss, benchmarks, behaviour 等來衡量;另一個是從系統工程 (System) 的視角,考慮如何能夠更快做推理服務用戶、如何更快迭代實驗等等,由 latency, throughput, memory cost 等來衡量。
只有模型視角,你會得到一組效果很好、但達不到延遲、顯存或成本要求的權重;只有系統視角,你會得到一個很高效、但學不到足夠東西的模型。
AttnRes 裡有三處是系統決定模型:
- Block AttnRes 本身:Full AttnRes 在流水線並行下要傳 O(Ld) 的層輸出,當前的互聯帶寬扛不住,所以才有了塊。
- 偽 query 不依賴輸入:這是第二層批量計算成立的前提。消融裡依賴輸入的 query 其實更好,但沒有被採用。
- 塊數固定在 8 個左右:Full AttnRes 的效果最好,更細的分塊也更接近它;作者明說,固定 N≈8 是出於 infra 效率,等硬件放鬆了再換更細的粒度。
同樣的結構也出現在學術界的工作裡。另一個學術團隊在 AttnRes 之後提出的 Depth Memory(LDM)能在深度方向用精確的遞推最小二乘(RLS),是因為層本來就是順序計算的,不需要序列方向那種可並行的近似解;RLS 又恰好可逆,於是反向傳播時可以從最後一層倒推狀態,省掉逐層存儲。
但兩篇論文的系統層回答的問題不同。Kimi 是在 48B MoE 上做驗證、目標是用到生產模型裡的工業團隊,關心流水線通信、長上下文 prefill 和部署延遲;Depth Memory 是學術組,關心單卡 kernel 速度和激活顯存。系統層回答什麼問題,往往取決於研究人員所在的位置。
所以,讀架構論文時,值得對每個設計的選擇都問一句:這個取捨是為了效果,還是為了系統?系統工程能力是萬萬不可缺的,很多設計都是由工程驅動的。
(想到一句流行的說法: “教一個 Researcher 如何做好 Engineering,要遠比教一個 Engineer 如何做好 Research 來得難”。)
如何學這三層
作為研究者,沒必要三層都深入瞭解,對於每一個層次做到讀得懂(知道為什麼這樣設計)、會使用對應的簡單框架就好了。並且可以選擇一塊深入研究,和不同能力的朋友合作。
1. 模型定義層
(a) 需要具備什麼能力
- 熟悉現代模型的各個組件,知道每個設計在解決什麼問題、付出什麼代價:attention 及其變體(MHA、GQA、MLA、稀疏與線性注意力、狀態空間模型)、歸一化的位置、殘差與深度方向的信息流、MoE、位置編碼。
- 理解訓練的規律:scaling law;訓練穩定性(初始化、學習率與 warmup、loss spike);超參數如何隨規模遷移。
- 能精讀論文:還原作者的論證,區分“作者的觀點”和“實驗數據實際支持什麼”;以及可以換位思考一下,如果你是作者,你會怎麼論證和實驗?
- 能設計嚴謹的實驗:控制變量、消融、多個 seed、多個尺寸的趨勢、為每個方法單獨調參,用小規模實驗得到可信的結論。
- 能找到好問題:從數據和主流說法對不上的地方(比如作者敘述和自己實驗對不上的地方、兩篇論文的數據矛盾的地方等等),或者從跨領域的類比裡找切入點。
(b) 資源
- 課程:Stanford CS336(Language Modeling from Scratch);Berkeley Scalable AI 的架構與預訓練部分。
- 經典代碼:nanoGPT 這類精簡實現;OLMo 這類代碼、數據、訓練日誌全部公開的模型。
- 經典論文:Transformer 原文;Chinchilla 的 scaling law;近年開源模型的技術報告,如 DeepSeek-V3、Qwen3。
2. 算法層
(a) 需要具備什麼能力
- 估算成本:給一個算子估算計算量和顯存讀寫量,判斷瓶頸在哪裡。
- 重排計算:利用結合律、分塊、遞推形式與並行形式的轉換,找到結果相同、成本更低的算法。典型例子是 online softmax 和線性注意力的分塊並行算法。
- 數值線性代數與數值穩定性:矩陣分解、最小二乘、低秩結構;知道低精度下哪裡會溢出或失準。
- 把模型改動翻譯成算法問題:一個新結構能不能並行?能不能分塊?中間結果能不能不存?
(b) 資源
- 論文:FlashAttention 1、2,硬件感知算法設計的範本;Mamba-2 的 SSD 論文(Transformers are SSMs),線性注意力與狀態空間模型的統一視角。
- 博客:Songlin Yang 的 DeltaNet 系列;蘇劍林的“科學空間”。
- 教材:Trefethen 和 Bau 的《Numerical Linear Algebra》。
3. 系統層
(a) 需要具備什麼能力
- 理解 GPU 的性能模型:顯存層級(HBM、SRAM、寄存器)、tensor core、roofline、memory-bound 與 compute-bound、kernel 融合。
- 算清訓練的顯存賬:參數、梯度、優化器狀態、激活各佔多少;重計算如何用時間換空間。
- 理解分佈式訓練:數據並行與 FSDP、張量並行、流水線並行、專家並行,各自要傳什麼、通信成本多大。
- 理解推理系統:prefill 與 decode、KV cache、批處理與調度。
- 理解數值精度:BF16、FP8、FP4 各自的取捨。
- 會用工具:用 profiler 找瓶頸;必要時用 Triton 寫簡單的 kernel。
(b) 資源
- 入門直覺:Horace He 的 Making Deep Learning Go Brrrr From First Principles。
- 大模型系統:How to Scale Your Model;Hugging Face 的 Ultra-Scale Playbook;vLLM、SGLang 的文檔與源碼。
- 動手:Triton 官方教程;GPU MODE 社區講座;《Programming Massively Parallel Processors》。
- 課程:UC Berkeley Scalable AI 的性能、並行與推理部分;UC Berkeley CS 61C 體系結構基礎。
順序上,建議先建立基礎的 ML 認識,從第一層的讀論文和做實驗入手,發現知識盲區再選擇性地找優質資源學習。通過讀論文和優質課程,慢慢建立第三層的性能直覺,然後回看第二層的算法推導——這兩層總是交替的。
貫穿三層的練習項目
最好的學法是用一個項目把三層串起來,每一步都落在其中一層上。不必從零設計,現成的課程作業就很好:
- Stanford CS336 的 A2:用 Triton 實現 FlashAttention,再做分佈式訓練,正好覆蓋算法層和系統層。
- UC Berkeley Scalable AI 的 A1(性能工程):作業包在課程主頁有開源,是關於性能分析的基本功。
做完之後,可以挑一篇自己感興趣的架構論文,按三層各走一步:先在小模型上用 PyTorch 把它實現出來(模型層),再用 profiler 找出瓶頸(系統層),最後試著重排計算,或者寫一個融合 kernel(算法層和系統層)。
碎碎念
模型層決定做什麼,算法層和系統層決定能不能做大、投入生產使用。好的架構研究,是在這三層之間來回調整的結果。第一層需要建模與實驗的能力,後兩層則與 MLSys 相關。
但是但是,回到初心,最重要的還是 Mindset,你是否真正熱愛這個領域,是否願意慢下來、靜下來,一步一步地向前走。
ML 研究不容易,基礎要慢下來一點一點打牢。最近讀到教授們發起的"慢科研聯盟"倡議,深以為然。可現在大家普遍焦慮,而 AI 的飛速發展像一面放大鏡,把這種焦慮放得更大。對我來說,焦慮的核心是年齡,總想再早一點做出成績。
做 ML 研究,對我而言或許是命中註定的,它是我願意傾盡一生的事業之一。兜兜轉轉,人總會回到屬於自己的位置。高二那年,我記得下課後和一位很要好的朋友討論數學,那時我們都在學線性代數。瞭解到機器學習之後,我們說,高考後一定要做這方面的研究。很神奇,從第一次接觸這個領域起,我就一直被它吸引,直到今天。本科三年過去,我嘗試了全棧開發、區塊鏈、量化投研乃至自己創業做項目做品牌,繞了一大圈。直到第四年,再次回到這裡。
我願意慢慢來,因為從畢生事業的角度看,多等一年和快進一年並沒有多少區別。以及我熱愛的是做研究本身,每天能夠學習前沿新知、有所思考,真的特別幸福。
但慢下來也要求你有所成果,現實的評判體系根深蒂固。加之每個人隨著年齡增長都需要面對世俗層面的取捨,二十幾歲的青春年華眨眼逝去,社會時鐘的壓力讓我們不得不腳踏具體又粗糙的現實。
我想,戰略上要儘可能提升自己的迭代速率,在照顧好身體和生活的前提下,提高學習和實驗的效率,把時間聚焦於對的方向;具體到研究本身,則需要慢慢來,紮實把事情做好:)
Reference
- Attention Residuals(Kimi Team, arXiv:2603.15031)
- Depth Memory(arXiv:2610.18809)
- Scalable AI, Fall 2026(UC Berkeley)
( Berkeley)